Una alarma de ventilador es el inicio del diagnóstico
Una alarma del BMC identifica una condición; por sí solo no prueba que se haya restablecido la ruta del flujo de aire.
La guía de servicio de NVIDIA identifica un módulo de ventilador fallido a través de tres vistas independientes: telemetría del sensor BMC, la herramienta de estado del sistema operativo y un LED del módulo físico. Los tres deben ponerse de acuerdo antes de tocar el hardware y luego se confirma el reemplazo a través de las mismas tres vistas. Esa secuencia de triple verificación es específica de la plataforma en sus detalles pero universal en su lógica, y vale la pena copiarla incluso en hardware donde no existe tal manual.
Antes de retirar cualquier módulo, capture el estado en el que se disparó la alarma: identidad del módulo y número de compartimento, tipo de alarma y marca de tiempo, servicio PWM ordenado, RPM informado para cada módulo del conjunto, temperatura de entrada y las temperaturas de los componentes a los que sirve ese módulo. Una fotografía de la pantalla del sensor BMC es un registro de campo legítimo. Sin esta instantánea, la comparación posterior al reemplazo no tiene nada con qué comparar.
Un RPM normal confirma que un rotor está girando. No puede confirmar que llegue aire útil a un disipador de calor cargado. Una entrada bloqueada, un cable tendido a través del conducto, un módulo invertido, un filtro parcialmente colapsado o un vecino fallido que ha convertido una bahía en una ruta de retorno pueden hacer que la velocidad reportada parezca plausible mientras que la función de enfriamiento entregada es incorrecta. Combine la telemetría del ventilador con la temperatura de entrada, la telemetría de los componentes y, cuando sea práctico, una verificación de la presión o del flujo de aire suministrado.
La denominación de las alarmas difiere entre plataformas: un proveedor puede registrar una falla del ventilador como un código de evento numérico, mientras que otro expone estados de sensores nombrados, como umbrales críticos más bajos o no recuperables. Las cartas no se transfieren entre proveedores. La secuencia hace lo siguiente: confirmar qué bahía, confirmar lo que cree la ruta de administración, confirmar qué está haciendo realmente la ruta de aire y luego decidir si la solución es un módulo, un conducto, un filtro o una configuración de control.
Lo que el BMC puede y no puede probar
La telemetría del ventilador demuestra la rotación, el seguimiento de comandos y la salud del camino de gestión, nada más.
Un controlador de gestión de placa base gana su valor al hacer que el enfriamiento sea observable. Dependiendo de la plataforma, puede informar RPM por módulo, la función PWM que el controlador cree que ha emitido, la presencia e identidad del módulo y, en algunos diseños, la corriente de entrada o una presión diferencial del chasis. Esas lecturas son las que hacen que la redundancia N+1 sea verificable: sin un canal RPM por bahía no hay forma de saber que falta un módulo hasta que se activa una alarma térmica.
El límite es que casi todo lo que informa el BMC es una cantidad eléctrica o rotacional. El ciclo de trabajo es un comando, RPM es una medida del rotor y la corriente es una medida del motor. El flujo de aire entregado no es ninguna de esas cosas. Depende de la condición del impulsor, la resistencia del conducto, la dirección en la que se instaló el módulo y el comportamiento de los módulos vecinos. Un circuito de control que se haya sintonizado solo con RPM mantendrá felizmente un flujo de aire incorrecto a una velocidad correcta.
El diseño del umbral merece el mismo escrutinio que la selección del sensor. Una alarma de ventilador configurada solo en una condición de rotor bloqueado cero-RPM no detectará un módulo que se ha desacelerado en un tercio porque su cojinete está fallando, y no detectará un módulo cuyo flujo de aire se haya colapsado detrás de un conducto bloqueado mientras el rotor gira más rápido de lo habitual contra la restricción. Cuando la plataforma exponga un umbral crítico más bajo, configúrelo en relación con la función ordenada en lugar de como un único número absoluto: un módulo comandado al 40 % que informa que el 40 % está en buen estado y un módulo comandado al 100 % que informa que el 62 % no lo está.
La conclusión práctica es que el BMC es un indicador rápido, económico y continuo de la mitad eléctrica del enfriamiento, y un pobre indicador de la mitad aerodinámica. Úselo para detectar cambios y desencadenar una investigación, luego confirme con la temperatura y, cuando el riesgo lo justifique, con una medición del flujo de aire o de la presión.
La redundancia es una reserva de velocidad, no una pieza de repuesto
N+1 funciona sólo porque los módulos supervivientes tienen un lugar adonde ir cuando uno se detiene.
El instinto es leer N+1 como "un ventilador de repuesto". Esa lectura produce diseños que fallan en la primera falla real. La lectura correcta es que el tamaño de la matriz es tal que los módulos restantes puedan absorber la pérdida, lo que significa que el estado saludable debe ejecutarse deliberadamente por debajo del máximo. La práctica común de la industria es operar módulos en funcionamiento alrededor del 70% de la velocidad máxima y mantener aproximadamente un 30% de margen de velocidad específicamente para la compensación de fallas, luego hacer que el controlador aumente a cada superviviente hasta el 100% cuando una bahía se cae.
La compensación no es marginal. El comportamiento de campo informado para plataformas 2U muestra que los módulos supervivientes aumentan su velocidad entre un 20 y un 40 % aproximadamente para cubrir una sola pérdida, y el controlador tiene que hacerlo lo suficientemente rápido como para que los disipadores de calor nunca vean el déficit. Se siguen dos consecuencias. En primer lugar, la reserva debe validarse con un módulo realmente retirado o detenido, en el peor de los casos con la carga y la peor temperatura de entrada; un modelo no es una prueba de aceptación. En segundo lugar, una vez gastada la reserva no queda un segundo margen de fallo, por lo que la alarma que anuncia el fallo también está anunciando un plazo.
Ese plazo cuesta caro en tres monedas. La producción acústica aumenta aproximadamente con la quinta potencia de la velocidad de rotación, por lo que una rampa sostenida hasta la velocidad máxima es mucho más que un aumento proporcional del ruido. La carga del motor y de los cojinetes aumenta, y el modelo de vida útil que se aplica a un módulo que funciona al 70 % no es el modelo que se aplica a uno que se mantiene al 100 %. Al mismo tiempo aumenta el consumo de energía auxiliar, lo que es importante en instalaciones donde la energía del ventilador se mide por separado. Por lo tanto, la redundancia no es disponibilidad gratuita: es disponibilidad adquirida a un costo conocido en estado estacionario, y el diseño debería decirlo explícitamente.

| Configuración | lo que tolera | Uso típico |
|---|---|---|
| N | Ningún fracaso. Cualquier pérdida de módulo reduce el enfriamiento por debajo del requisito | Recintos no críticos, mesas de laboratorio. |
| N+1 | Cualquier falla de un solo módulo, a plena carga. | Servidores, gabinetes de telecomunicaciones, BESS HVAC |
| N+2 | Dos fracasos simultáneos | Sitios remotos o no tripulados donde el servicio tarda días |
| 2N | Se perdió una matriz completa | Instalaciones de misión crítica y de defensa. |
El reflujo convierte un módulo inactivo en una fuga
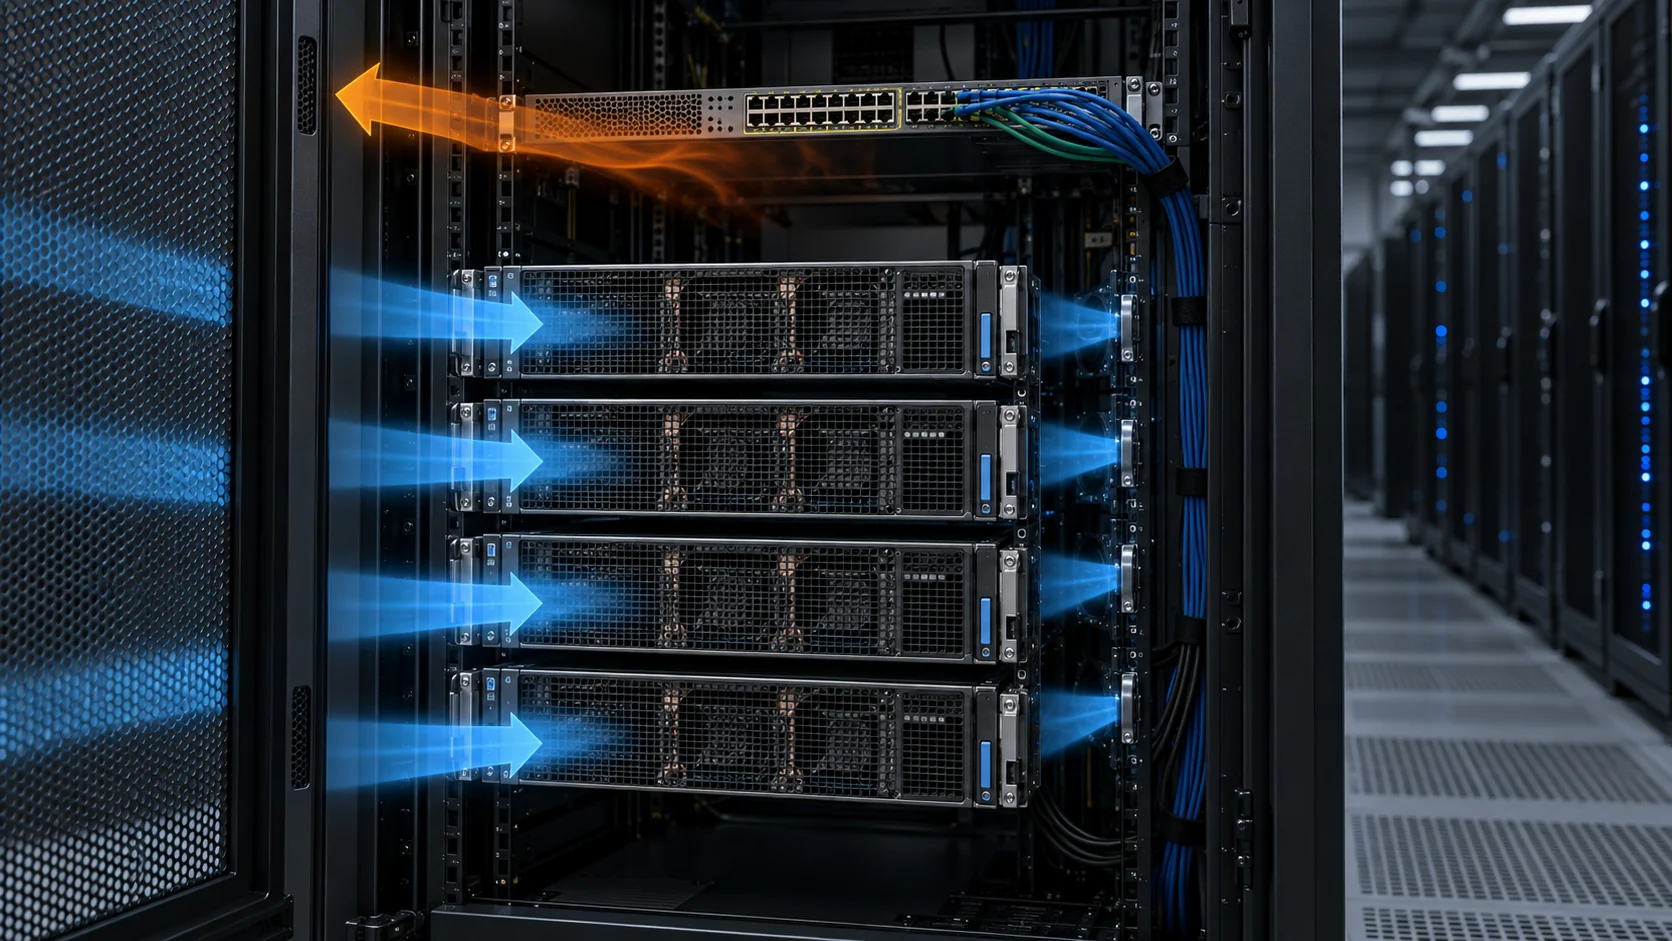
Un rotor detenido es un orificio abierto en el camino del aire y el aire lo utilizará.
Los módulos de una matriz de servidores se encuentran en paralelo y las rutas paralelas comparten la misma diferencia de presión. Cuando una bahía deja de mover aire, presenta la menor resistencia en el chasis, por lo que una fracción del aire empujada por los supervivientes regresa a través de ella en lugar de cruzar los disipadores de calor. Este es el mecanismo detrás de una falla que parece térmicamente imposible en una primera inspección: la matriz está funcionando a pleno rendimiento, la alarma se ha eliminado y un componente posterior aún está caliente.
El efecto es local, que es lo que dificulta verlo. El flujo de aire a nivel del chasis puede estar dentro de la tolerancia, mientras que la región inmediatamente aguas abajo de la bahía inactiva se muere de hambre. Los supervivientes también se mueven a un punto diferente en su curva de presión-flujo cuando cambia la resistencia del sistema, por lo que el flujo entregado por módulo no es simplemente la cifra saludable dividida por el número de módulos en funcionamiento.
Existen respuestas mecánicas y electrónicas. Las rejillas accionadas por gravedad o resorte y las compuertas contracorriente se cierran cuando una bahía deja de mover aire, lo que se dirige directamente al camino y funciona sin ninguna acción de control. Cuando las contraventanas no son prácticas, la estrategia del controlador es sobrecargar a los supervivientes lo suficiente como para que la diferencia de presión a través del compartimento inactivo se invierta sólo brevemente, y utilizar la señal de detección de rotación o de rotor bloqueado del módulo como disparador en lugar de esperar una alarma de temperatura. La detección debe tratarse como un elemento de control, no como una notificación.
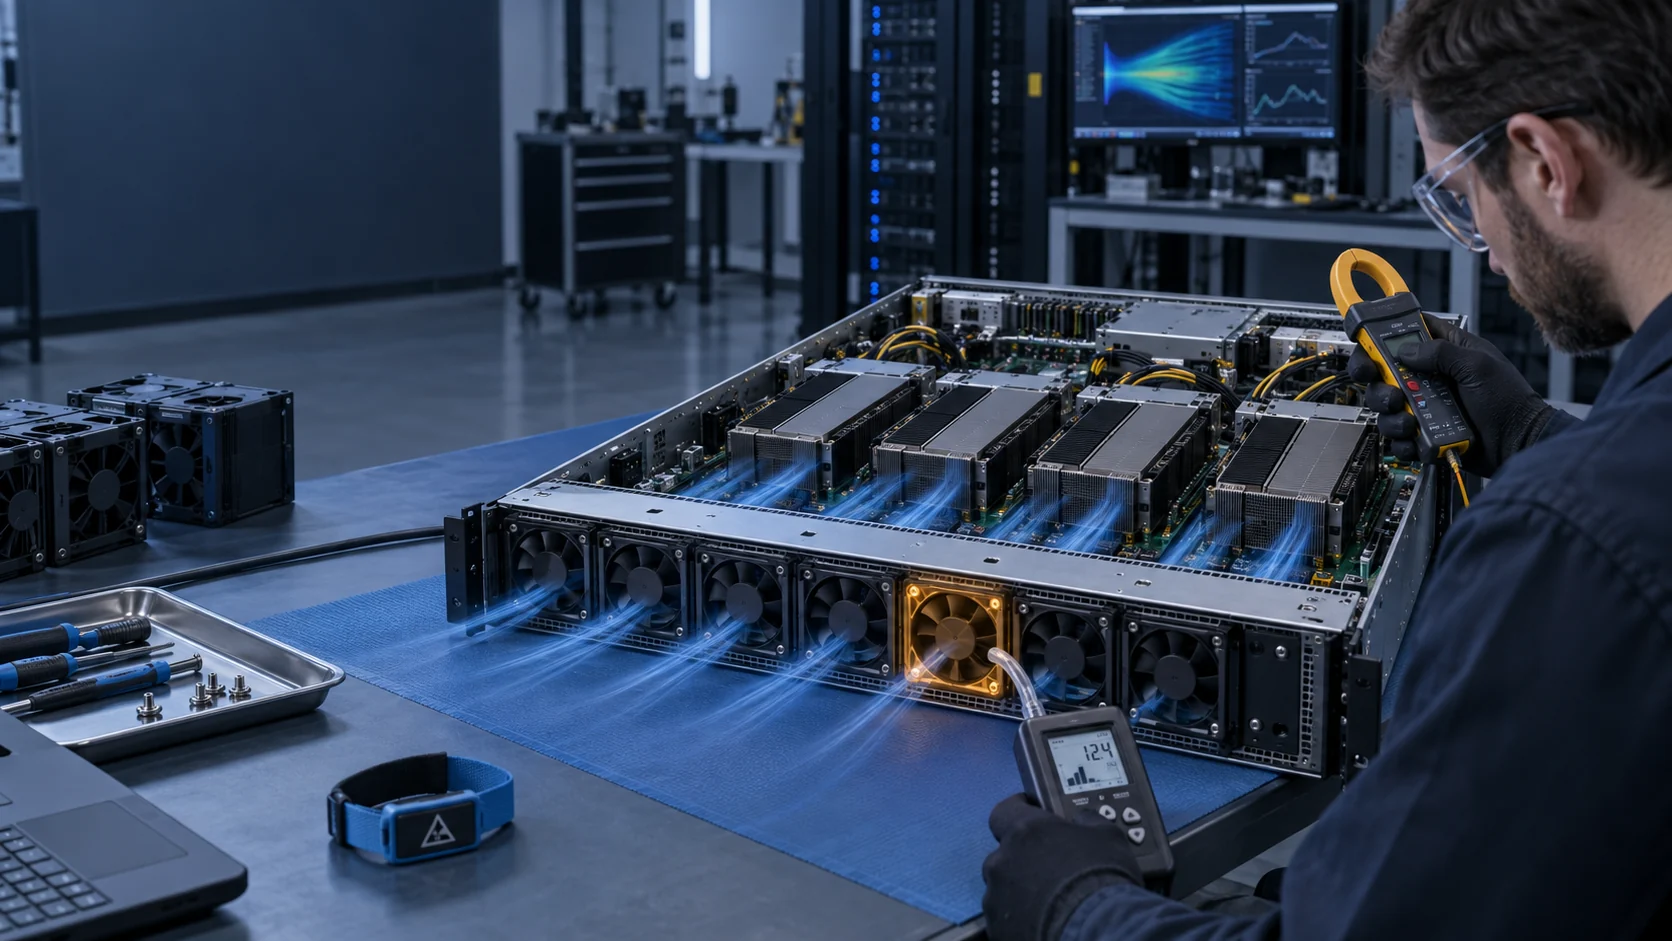
Validar la condición en lugar de asumir que la mitigación funciona. Con el módulo fallido todavía en su lugar y detenido, pruebe el flujo inverso en esa bahía (un anemómetro de paletas sostenido en la apertura inactiva a menudo mostrará la dirección con suficiente claridad) y compare las temperaturas de los componentes aguas abajo de la bahía inactiva con sus límites aceptados. Si el chasis depende de que se ordene a los supervivientes que alcancen la máxima velocidad en unos pocos segundos, la latencia del comando también forma parte de los criterios de aceptación.
La validación de reemplazo tiene cuatro controles
El ajuste mecánico, el comportamiento eléctrico, el funcionamiento del flujo de aire y la visibilidad de la gestión deben coincidir antes de aceptar un reemplazo.
Trate un cheque como fallido si no existe evidencia de ello. Un módulo de reemplazo que se ajusta, gira y desactiva la alarma pasó dos controles y no produjo evidencia de los otros dos, que es exactamente el estado en el que se puede ocultar una segunda falla más lenta.
| Controlar | Registro | Por qué es importante |
|---|---|---|
| Mecánico | Marco, espesor, dirección del flujo de aire, pestillo y acceso de servicio | Un conector correcto no demuestra una ruta de aire correcta |
| Eléctrico | Rango de voltaje, corriente de entrada, conector, PWM, FG/RD y comportamiento de reinicio | Evita fallos de control o protección tras el swap. |
| Térmico | Temperatura de entrada, temperaturas de componentes clave y presión o evidencia de flujo entregado | Muestra el servicio de refrigeración instalado, no solo la rotación. |
| Gestión | Identidad del módulo BMC, borrado de alarmas y estado de velocidad real | Hace que el reemplazo sea compatible en servicio. |
La ventana de servicio es un parámetro de diseño
Cuánto tiempo sobrevive el chasis sin un módulo es una especificación, no una esperanza.
La ventana de reemplazo de 30 segundos indicada en el procedimiento del ventilador DGX A100 de NVIDIA es el ejemplo publicado más claro de una restricción de servicio que se trata como parte del diseño térmico. No es una regla general y no es un objetivo que otras plataformas deban tomar prestado. Es una consecuencia de la masa térmica de ese chasis, su disposición del flujo de aire y la carga de trabajo que estaba ejecutando el sistema. Lo que importa es que alguien lo midió y lo anotó.
La mayoría de las instalaciones no tienen un número equivalente. El resultado es que el reemplazo del ventilador lo programa quien esté disponible, y una matriz que ha estado funcionando en su reserva durante tres días se trata con normalidad. Una mejor práctica es derivar el número y publicarlo: tomar el chasis en su peor caso de carga y peor temperatura de entrada, quitar o detener un módulo y medir cuánto tiempo tardan las temperaturas de los componentes en alcanzar sus límites con los supervivientes al mando total. Esa duración, menos un margen de ingeniería, es la ventana de servicio.
El número alimenta entonces tres decisiones. Establece la prioridad de la alarma: una falla en un diseño con una ventana de 40 minutos es una tarea de mantenimiento programada, mientras que la misma falla en un diseño con una ventana de dos minutos es una emergencia. Establece la política de repuestos, incluyendo si se requiere stock en sitio. Y pertenece a la prueba de aceptación, porque no se ha validado un procedimiento de sustitución que no se puede ejecutar dentro de la ventana, por muy bien que funcione el módulo.
Interactivo: Alerta BMC sobre recuperación térmica
Utilice las etapas siguientes como un registro de validación, no como un proceso de aprobación automático.
El siguiente modelo visualiza tres estados: funcionamiento con carga normal, un módulo no disponible y reemplazo con reinicio. Revíselos en orden y pregunte si el camino de gestión, la respuesta de los supervivientes y la evidencia térmica posterior al reemplazo cuentan la misma historia. El objetivo del ejercicio es encontrar el estado en el que no están de acuerdo, porque ese es el estado que luego se convierte en una interrupción no planificada.
Comportamiento de control después del reemplazo
Un módulo que funciona por sí solo puede no funcionar en el conjunto al que se ha unido.
Dos módulos con el mismo tamaño de estructura, el mismo voltaje y la misma velocidad nominal aún pueden tener diferentes curvas de velocidad versus servicio. Cuando uno de ellos tiene una pendiente significativamente mayor que sus vecinos, el controlador impone la misma tarea a todos ellos y obtiene una velocidad diferente de cada uno. En una matriz sana esto es invisible. Durante una rampa de falla, se vuelve visible rápidamente, porque el módulo que alcanza primero la velocidad máxima es el que establece el pico acústico y de corriente, mientras que su vecino más lento todavía está alcanzándolo.
La retroalimentación de rotación tiene el mismo problema en un lugar menos obvio. Las señales del tacómetro y de detección de rotación no están estandarizadas entre los fabricantes: los pulsos por revolución, la polaridad de salida y la transmisión de colector abierto versus push-pull pueden diferir. El BMC puede leer un reemplazo que sea mecánica y eléctricamente correcto pero que presente una característica de tacómetro diferente como un módulo en buen estado que informa una velocidad incorrecta, y una lectura de velocidad incorrecta es peor que ninguna lectura, porque el circuito de control actuará sobre ello.
La salvaguardia práctica es una breve prueba del circuito de control después de cualquier reemplazo. Ordene la matriz a través de un barrido a toda velocidad, un regreso al trabajo y una retención en estado estable, y registre RPM por módulo junto con el comando. La matriz pasa si cada módulo sigue el comando con una forma similar y ninguno de ellos oscila, caza o se retrasa de manera persistente. Luego repita la verificación con un módulo detenido, de modo que se ejerza la rampa de supervivientes en lugar de asumirse.
Especifique la vida útil para el servicio real 24 horas al día, 7 días a la semana
Una figura L10 pertenece a su temperatura, voltaje, orientación, velocidad y supuestos de prueba, nunca por sí sola.
Las cargas de trabajo de IA mantienen los ventiladores compactos a velocidad elevada durante largos períodos, que es precisamente la condición que acorta la vida útil de los rodamientos. Vale la pena comprender los métodos de prueba L10 publicados y utilizados por los principales fabricantes de ventiladores antes de comparar dos cifras de vida útil: una muestra estadísticamente significativa se procesa continuamente al 100% del servicio PWM en un entorno controlado, a menudo con una temperatura elevada utilizada como factor de aceleración, y la clasificación se expresa como el número de horas en las que se espera que el 10% de la muestra haya fallado por desgaste.
Dos correcciones importan en el servicio. La vida útil de la grasa para rodamientos se reduce aproximadamente a la mitad por cada 10 a 15 K por encima de la temperatura ambiente nominal, por lo que un ventilador con clasificación de 60 °C instalado detrás de una fuente de calor a 75 °C no tiene la vida útil impresa en su etiqueta. La velocidad actúa en la otra dirección: la vida útil de los rodamientos aumenta aproximadamente cuando la relación entre la velocidad nominal y la velocidad real se eleva a aproximadamente 1,5, que es la versión cuantitativa del argumento a favor de sobredimensionar un ventilador y hacerlo funcionar por debajo del máximo. El funcionamiento start-stop, la orientación del montaje, la contaminación y la vibración modifican aún más el resultado.
MTBF no sustituye a L10 y no debe leerse durante toda la vida. Describe la tasa de fallas aleatorias durante la parte de la curva de vida útil; el desgaste (cojinetes, grasa, condensadores electrolíticos) es lo que realmente pone fin al servicio de un ventilador. Una especificación que cita un MTBF de un millón de horas y omite la condición L10 no le dice nada al lector sobre cuándo comenzarán a salir los módulos de la matriz.
MEGA Tech puede revisar un módulo de referencia de enfriamiento normal de una matriz de servidores de IA y desarrollar un candidato personalizado en torno al marco y el grosor requeridos, la dirección del flujo de aire, la presión y el flujo, la señalización PWM y FG/RD, el conector y la distribución de pines, la construcción de los rodamientos y las condiciones ambientales. Un candidato es liberado solo después de una validación eléctrica, térmica y de control representativa por parte del equipo del equipo, frente a los puntos de aceptación que han definido.
Series de ventiladores recomendadas para empezar
Estas series del catálogo pueden ser un punto de partida para esta aplicación. La selección final depende del caudal, la presión estática, la tensión, el objetivo de ruido y el entorno de trabajo instalados.
Solicite una muestra para validarla en su equipo.
Preguntas frecuentes de los ingenieros: confiabilidad del ventilador del servidor AI
Utilice estas preguntas antes de aprobar un reemplazo o una muestra personalizada.
P: ¿Una alarma BMC eliminada demuestra que se restablece el enfriamiento? R: No. Esto demuestra que el camino de la gestión ve un estado saludable. Compare las temperaturas de entrada y de los componentes relevantes bajo una carga representativa y verifique que el conjunto aún mantenga la reserva prevista por el diseño.
P: ¿Se puede tratar un marco y un voltaje coincidentes como un reemplazo directo? R: No. La dirección, el conector y la distribución de pines, la corriente de arranque y de irrupción, la semántica de PWM y FG/RD, el servicio de presión-flujo instalado y el margen térmico resultante deben validarse por separado del ajuste mecánico.
P: ¿Cuánto tiempo puede funcionar el chasis sin un módulo? R: Esa es una propiedad de diseño, no una cifra general. Mídalo en el peor de los casos con carga y temperatura de entrada con los supervivientes al máximo control, luego aplique un margen y publique el resultado como ventana de servicio. Si nadie lo ha medido, el número aún no existe.
P: ¿Por qué a veces un módulo de repuesto lee la velocidad incorrecta en el BMC? R: Las características del tacómetro no están estandarizadas. Los pulsos por revolución, la polaridad de salida y el tipo de unidad pueden diferir entre los fabricantes, por lo que el controlador de gestión puede interpretar una señal correcta como una velocidad incorrecta.
P: ¿Qué se debe proporcionar a MEGA Tech para una revisión de muestra? R: La etiqueta del ventilador o la hoja de datos, el dibujo del módulo, la dirección del flujo de aire, el voltaje de suministro, el conector y la distribución de pines, las señales de control, los puntos de aceptación térmica, las condiciones de entrada, el ruido objetivo, el ciclo de trabajo esperado y la cantidad.
Preguntas para una revisión de diseño
Llévelos a la revisión del diseño de refrigeración, no a la primera falla de hardware.
- ¿Qué reserva de velocidad tiene el conjunto en funcionamiento normal y qué medición demuestra que todavía está disponible después de un año de servicio?
- ¿Cuál es la ventana de servicio validada con un módulo detenido en el peor de los casos con carga y temperatura de entrada?
- ¿Qué componentes se encuentran inmediatamente aguas abajo de una bahía fallida y qué sucede con su temperatura cuando esa bahía se detiene?
- ¿Tiene el chasis contraventanas, amortiguadores o una respuesta de control que limite el flujo inverso a través de un compartimento inactivo y se ha medido?
- ¿Se registran los estados de alarma, comando y RPM por módulo por bahía, de modo que se pueda comparar una segunda falla con la primera?
- ¿La característica del tacómetro del módulo especificado coincide con lo que espera el controlador de gestión? ¿Está indicado por escrito?